我从零训练了一个 30M 的运维小模型:OpsLM-Toy 第一阶段复盘
这不是一篇“调用现成框架训练模型”的教程,而是我真的从 Tokenizer、Embedding、Self-Attention、Multi-Head Attention、MLP、Transformer Block 一层一层写起,最后把一个随机初始化的 Decoder-only Transformer 训练到能生成运维文本。
这篇文章记录的是第一阶段实验。目标不是训练出一个真正可用的大模型,而是把“语言模型到底是怎么从文本一路变成 loss,再通过反向传播学到东西”这条链路完整走通。
代码仓库(后续会持续整理并开源):
https://github.com/noovertime7/opslm-toy
仓库开源后,想直接复现实验可以先:
git clone https://github.com/noovertime7/opslm-toy.git
cd opslm-toy
1. 为什么我要做这个实验
我平时做 SRE,也一直在接触智能体、推理服务、GPU、vLLM、Kubernetes、AI Infra 这些东西。以前我对大模型很多概念都知道一点,比如 Token、Embedding、Attention、Transformer、Loss、反向传播,但是如果真让我从一张白纸开始把一个语言模型写出来,我其实并没有完整做过。
所以这次我给自己定了一个目标:
不使用现成的 GPT 模型,不加载预训练权重,从随机参数开始,亲手写一个小型 Decoder-only Transformer,然后用我自己准备的 SRE/AI Infra 语料把它训练起来。
第一阶段我把这个模型叫做:
OpsLM-Toy-30M
它的定位很明确:
- 不是为了生产使用;
- 不是为了追求 Benchmark;
- 不是为了和现成开源模型比能力;
- 而是为了让我真正理解一个 Base Model 是怎么“出生”的。
这次实验最后是成功的,而且成功得有点过头:训练 loss 最后降到了约 0.000959,模型几乎把我那点小语料背下来了,也让我第一次非常直观地看到了什么叫 过拟合。
2. 实验环境
我租了一台 GPU 机器,主要环境如下:
OS: Ubuntu 24
GPU: NVIDIA GeForce RTX 5090
显存: 32GB
Python: 3.11
环境管理: Conda
框架: PyTorch
Tokenizer: Hugging Face tokenizers
项目目录:
/root/opslm-toy
Conda 环境:
conda create -n opslm python=3.11 -y
conda activate opslm
安装依赖:
python -m pip install torch tokenizers numpy tqdm
我后面尽量都使用:
python -m pip
而不是直接 pip,因为这样更不容易出现“包装到了别的 Python 环境”这种问题。
3. 第一版模型配置
我没有一上来就用 RoPE、RMSNorm、SwiGLU、FlashAttention、GQA 这些现代结构,而是先故意写一个最容易理解的经典版本。
第一版配置:
from dataclasses import dataclass


@dataclass
class ModelConfig:
    vocab_size: int
    max_seq_len: int = 1024
    d_model: int = 512
    n_heads: int = 8
    n_layers: int = 8
    d_ff: int = 2048
    dropout: float = 0.1

    def __post_init__(self):
        if self.d_model % self.n_heads != 0:
            raise ValueError(
                "d_model must be divisible by n_heads"
            )

    @property
    def head_dim(self):
        return self.d_model // self.n_heads
核心参数:
d_model      = 512
n_heads      = 8
head_dim     = 64
n_layers     = 8
d_ff         = 2048
max_seq_len  = 1024
目标 vocab   = 16000
这里有一个很重要的关系:
512 / 8 = 64
也就是说,每个 Attention Head 负责 64 维。
4. 项目目录
第一阶段最后整理成了大概这样的结构。第一次从空目录创建时,我执行的是:
mkdir -p opslm-toy/{data/raw,tokenizer/artifacts,src,scripts,logs,checkpoints}
cd opslm-toy

touch src/__init__.py
如果是从 GitHub 克隆,则不需要手动创建这些目录,直接:
git clone https://github.com/noovertime7/opslm-toy.git
cd opslm-toy
目录如下:
opslm-toy/
├── data/
│   ├── raw/
│   │   ├── general.txt
│   │   ├── linux.txt
│   │   ├── kubernetes.txt
│   │   ├── network.txt
│   │   ├── ai_infra.txt
│   │   └── production.txt
│   ├── merged.txt
│   └── cleaned.txt
│
├── tokenizer/
│   ├── train_tokenizer.py
│   ├── test_tokenizer.py
│   ├── analyze_tokenizer.py
│   └── artifacts/
│       ├── tokenizer.json
│       └── info.txt
│
├── src/
│   ├── __init__.py
│   ├── config.py
│   ├── embedding.py
│   ├── attention.py
│   ├── mlp.py
│   ├── block.py
│   ├── model.py
│   ├── dataset.py
│   └── prediction.py
│
├── scripts/
│   ├── clean_text.py
│   ├── test_embedding.py
│   ├── test_attention.py
│   ├── test_multihead_attention.py
│   ├── test_mlp.py
│   ├── test_block.py
│   ├── test_model.py
│   ├── test_dataset.py
│   ├── test_dataloader.py
│   ├── test_next_token_prediction.py
│   ├── train.py
│   └── generate.py
│
├── logs/
│   └── train.log
│
└── checkpoints/
    ├── step_000100.pt
    ├── ...
    └── final.pt
5. 准备第一批语料
第一版我没有追求大数据,只准备了几十 KB 的领域文本,主要是为了先把整个训练链路跑通。
内容包括:
- Linux;
- Kubernetes;
- 网络;
- AI Infra;
- GPU;
- 运维故障排查;
- 日志、监控、进程、系统命令;
- 一些通用计算机概念。
例如:
Linux 是一种广泛使用的开源操作系统。
Linux 内核负责进程调度、内存管理、文件系统、设备驱动和网络协议栈。
ps 命令可以查看系统中的进程。
top 命令可以实时观察系统负载和进程资源使用情况。
Kubernetes 部分则包含:
Pod 处于 Pending 状态时,可能是因为资源不足、调度限制或者存储问题。
Pod 出现 CrashLoopBackOff 时,通常表示容器启动后不断退出并重新启动。
kubectl logs 可以查看容器日志。
kubectl exec 可以进入容器执行命令。
AI Infra 则包括:
GPU 显存不足可能与 batch size、KV Cache、模型大小和并发有关。
Tensor Parallel 可以把一个模型切分到多张 GPU 上。
NCCL 常用于多 GPU 通信。
这批数据非常小,后面也正是因为太小,导致模型严重过拟合。
对应的原始数据文件放在:
ls -lh data/raw
我当时会先确认几个文件是否存在:
ls data/raw/general.txt \
   data/raw/linux.txt \
   data/raw/kubernetes.txt \
   data/raw/network.txt \
   data/raw/ai_infra.txt \
   data/raw/production.txt
查看语料行数:
wc -l data/raw/*.txt
6. 清洗文本
清洗脚本做的事情很简单:
- 去空行;
- 压缩多余空格;
- 去掉重复行;
- 合并
data/raw/*.txt; - 输出到
data/cleaned.txt。
第一阶段不追求复杂清洗策略,目标只有一个:
让语料能稳定进入 Tokenizer。
实际执行:
python scripts/clean_text.py
然后检查结果:
ls -lh data/cleaned.txt
wc -l data/cleaned.txt
head -n 20 data/cleaned.txt
如果要确认是否还有空行或异常内容,我还会直接:
sed -n '1,80p' data/cleaned.txt
7. 训练自己的 Tokenizer
这里我选的是:
Byte-level BPE
特殊 Token:
<pad> = 0
<unk> = 1
<bos> = 2
<eos> = 3
Tokenizer 的目标词表大小:
16000
但是因为第一阶段语料非常少,所以真正训练出来的词表远小于 16000。
这点很重要:
16000 是目标上限,不代表小语料一定能学出 16000 个有意义 Token。
训练命令:
python tokenizer/train_tokenizer.py
训练完成后确认文件已经落盘:
ls -lh tokenizer/artifacts/tokenizer.json
ls -lh tokenizer/artifacts/info.txt
测试 encode / decode:
python tokenizer/test_tokenizer.py
分析 Tokenizer:
python tokenizer/analyze_tokenizer.py
我当时重点测试的是:
kubectl get pods -n production
7.1 Byte-level BPE 里的 Ġ 是什么
我第一次测试:
kubectl get pods -n production
Tokenizer 输出类似:
'kubectl'
'Ġget'
'Ġpods'
'Ġ-'
'n'
...
这里的 Ġ 不是乱码,而是 ByteLevel Tokenizer 对“前面有空格”的一种内部表示。
例如:
'Ġget'
可以理解成:
' get'
真正 decode 时仍然会恢复正常文本。
7.2 我第一次真正理解 BPE 是怎么“学词”的
一开始 production 被拆得很碎:
Ġp
r
od
u
c
t
i
on
后来我专门加了一批包含 production 的训练句子:
production environment
production cluster
production namespace
kubectl get pods -n production
production workloads
production metrics
production logs
然后重新训练 Tokenizer。
这次 production 就开始被学成更完整的 Token。
我当时实际做的是:
# 修改或补充 production 相关语料后重新清洗
python scripts/clean_text.py

# Tokenizer 重新从头训练
python tokenizer/train_tokenizer.py

# 再次验证 production 是否被学成更完整的 Token
python tokenizer/test_tokenizer.py
这个实验让我第一次很直观地理解:
BPE 并不知道“production 是一个英文单词”,它只是根据频率不断合并经常一起出现的 byte/token 片段。
7.3 一个非常重要的原则
Tokenizer 可以在模型训练前反复重训。
但是一旦模型开始训练,就不能随便改 Tokenizer。
因为模型内部已经形成:
Token ID 731
↓
Embedding 第 731 行
如果重新训练 Tokenizer,731 代表的内容变了,那么以前训练出来的 Embedding 就全部对不上了。
8. Embedding:把 Token ID 变成向量
这一阶段完成代码后,我先做语法检查,再跑测试:
python -m py_compile src/embedding.py
python scripts/test_embedding.py
模型不能直接理解:
731
1074
1279
所以我们需要 Embedding。
完整核心实现:
import torch
import torch.nn as nn


class TokenAndPositionEmbedding(nn.Module):
    def __init__(
        self,
        vocab_size: int,
        d_model: int,
        max_seq_len: int,
        dropout: float = 0.1,
    ):
        super().__init__()

        self.token_embedding = nn.Embedding(
            num_embeddings=vocab_size,
            embedding_dim=d_model,
        )

        self.position_embedding = nn.Embedding(
            num_embeddings=max_seq_len,
            embedding_dim=d_model,
        )

        self.dropout = nn.Dropout(dropout)

    def forward(self, input_ids: torch.Tensor) -> torch.Tensor:
        batch_size, seq_len = input_ids.shape

        if seq_len > self.position_embedding.num_embeddings:
            raise ValueError(
                f"Sequence length {seq_len} exceeds "
                f"max_seq_len {self.position_embedding.num_embeddings}"
            )

        positions = torch.arange(
            seq_len,
            device=input_ids.device,
        )

        positions = positions.unsqueeze(0)
        positions = positions.expand(batch_size, seq_len)

        token_embeddings = self.token_embedding(input_ids)
        position_embeddings = self.position_embedding(positions)

        x = token_embeddings + position_embeddings
        x = self.dropout(x)

        return x
数据 Shape:
[B, T]
↓
[B, T, 512]
例如:
[4, 128]
↓
[4, 128, 512]
其中:
B = Batch Size
T = Sequence Length
512 = d_model
9. Self-Attention:让 Token 之间真正发生关系
对应的验证命令:
python -m py_compile src/attention.py
python scripts/test_attention.py
如果要直接观察 Causal Attention 权重矩阵:
python scripts/show_attention.py
这是我觉得最关键的一步。
输入:
[B, T, 512]
一个 Attention Head 先把每个 Token 投影成:
Q
K
V
每个都是:
[B, T, 64]
一个 Head 的核心公式:
Attention(Q,K,V)
=
softmax(QK^T / sqrt(d)) V
在我们的配置里:
d = 64
sqrt(64) = 8
所以 QK 的分数最后要除以 8。
9.1 为什么需要 Causal Mask
语言模型不能偷看未来。
比如:
A B C D
预测 C 时,只能看到:
A B
不能看到:
D
所以需要下三角 Mask:
1 0 0 0
1 1 0 0
1 1 1 0
1 1 1 1
未来位置在 softmax 前被设成:
-inf
这样 softmax 以后概率就是 0。
10. Multi-Head Attention
完成多头注意力后我直接跑:
python -m py_compile src/attention.py
python scripts/test_multihead_attention.py
还可以检查参数量和每个 Head 的输出 Shape。
单个 Head 输出:
[B, T, 64]
我们有 8 个 Head:
8 × 64 = 512
所以:
Head 1 -> 64
Head 2 -> 64
...
Head 8 -> 64
↓ concat
512
↓ out_proj
512
一个很重要的点:
我们没有规定某个 Head 一定负责语法、某个 Head 一定负责 namespace。
这些角色如果真的出现,也是训练过程中自己形成的。
第一阶段为了方便理解,我是用 8 个独立 Head 去实现的,这种写法好理解,但不高效。
真正的大模型一般会把 Q/K/V 一次性做大矩阵投影,然后 reshape 成多个 Head。
11. MLP
对应测试命令:
python -m py_compile src/mlp.py
python scripts/test_mlp.py
python scripts/test_attention_mlp.py
Transformer 不只是 Attention。
MLP 也非常重要。
我们的结构:
512
↓
2048
↓
GELU
↓
512
代码逻辑就是:
x = self.fc1(x)
x = F.gelu(x)
x = self.fc2(x)
我当时才真正意识到:
Attention 负责 Token 之间的信息交换,而 MLP 更像是每个 Token 自己内部的信息加工。
而且在这个模型里,一个 MLP 的参数量甚至比 Attention 还多。
12. Transformer Block
完成后:
python -m py_compile src/block.py
python scripts/test_block.py
python scripts/test_residual.py
第一版使用:
Pre-Norm
结构:
x
│
├──── LayerNorm -> Attention ────┐
│                                │
└────────────── + <──────────────┘
│
├──── LayerNorm -> MLP ──────────┐
│                                │
└────────────── + <──────────────┘
核心代码其实非常简单:
x = x + self.attention(self.ln1(x))
x = x + self.mlp(self.ln2(x))
这里的 + 就是 Residual Connection。
我现在对残差连接的理解是:
不是让每一层彻底推翻上一层的表示,而是在原表示基础上增加修改。
13. 组装完整 Decoder-only Model
完整模型第一次跑通时,我执行:
python -m py_compile src/model.py
python scripts/test_model.py
如果想观察显存,可以另开一个终端:
watch -n 1 nvidia-smi
最终结构:
Token IDs
↓
Token Embedding + Position Embedding
↓
Transformer Block 1
↓
Transformer Block 2
↓
...
↓
Transformer Block 8
↓
Final LayerNorm
↓
LM Head
↓
Logits
输入:
[B, T]
最后输出:
[B, T, Vocab]
也就是说,每个位置都会对词表里的所有 Token 打分。
13.1 LM Head 是什么
LM Head 本质就是:
512
↓
Linear
↓
vocab_size
比如 vocab 是 1500:
512 -> 1500
那么每个位置会得到 1500 个 logit。
这些 logit 不是概率。
训练时也不需要自己先 softmax,因为 CrossEntropyLoss 会直接处理 raw logits。
13.2 Weight Tying
我这里把:
Token Embedding
和:
LM Head
共享同一份权重。
代码:
self.lm_head.weight = self.embedding.token_embedding.weight
这样可以减少参数,也让输入 Token 表示和输出 Token 打分共享同一张参数表。
14. 参数初始化
完成初始化逻辑后:
python -m py_compile src/model.py
python scripts/test_initialization.py
如需保存“刚出生、还没有训练过”的模型:
mkdir -p checkpoints
python - <<'PY'
import torch
from tokenizers import Tokenizer
from src.config import ModelConfig
from src.model import OpsLMToy

torch.manual_seed(42)
tokenizer = Tokenizer.from_file("tokenizer/artifacts/tokenizer.json")
model = OpsLMToy(ModelConfig(vocab_size=tokenizer.get_vocab_size()))
torch.save(model.state_dict(), "checkpoints/opslm_toy_init.pt")
print("saved: checkpoints/opslm_toy_init.pt")
PY
我没有继续使用 PyTorch 默认初始化,而是自己统一:
Linear.weight   -> Normal(0, 0.02)
Linear.bias     -> 0
Embedding       -> Normal(0, 0.02)
LayerNorm.weight-> 1
LayerNorm.bias  -> 0
核心代码:
def _init_weights(module):
    if isinstance(module, nn.Linear):
        nn.init.normal_(module.weight, mean=0.0, std=0.02)
        if module.bias is not None:
            nn.init.zeros_(module.bias)

    elif isinstance(module, nn.Embedding):
        nn.init.normal_(module.weight, mean=0.0, std=0.02)

    elif isinstance(module, nn.LayerNorm):
        nn.init.ones_(module.weight)
        nn.init.zeros_(module.bias)
并且用:
torch.manual_seed(42)
固定随机种子,方便复现实验。
15. Dataset:Next Token Prediction 到底怎么构造
完成 Dataset 后先跑:
python -m py_compile src/dataset.py
python scripts/test_dataset.py
python scripts/show_next_token_data.py
重点确认:
Shift relationship correct: True
这是整个实验里另一个让我彻底理解的地方。
假设有:
A B C D E
训练数据不是:
Input = A B C D
Target = A B C D
而是:
Input  = A B C D
Target = B C D E
也就是 target 整体向后移动一个 Token。
因此如果 sequence length 是 128,就需要先取:
129 个 Token
然后:
input_ids = chunk[:-1]
target_ids = chunk[1:]
这就是 Next Token Prediction。
16. DataLoader
对应测试:
python scripts/test_dataloader.py
python scripts/test_dataset_model.py
预期能看到:
Input IDs:  [B, T]
Target IDs: [B, T]
Logits:     [B, T, V]
Dataset 返回:
[128]
DataLoader 如果 batch size 是 16:
16 × [128]
最后自动堆成:
[16, 128]
这就是模型真正收到的:
[B, T]
Token ID 必须使用:
torch.long
因为 nn.Embedding 输入的是索引,而不是浮点数。
17. 第一次真正开始训练
正式训练前,我先做一个非常小的 smoke test:
python -m py_compile scripts/train.py

python scripts/train.py \
  --max-steps 10 \
  --batch-size 16 \
  --seq-len 128 \
  --save-every 10 \
  --log-every 1
只有这 10 step 正常跑通后,我才开始后台训练 2000 step。
训练配置:
max_steps      = 2000
batch_size     = 16
seq_len        = 128
learning_rate  = 3e-4
warmup_steps   = 100
optimizer      = AdamW
mixed precision= BF16
之所以一开始用 128,而不是 1024,是因为我的第一批数据太小。
小数据阶段先用短 sequence 更适合验证链路。
17.1 一个 Training Step 到底发生什么
一次训练其实就是:
Input
↓
Forward
↓
Logits
↓
Cross Entropy
↓
Loss
↓
Backward
↓
Gradient
↓
Optimizer Step
↓
参数发生变化
核心代码:
with torch.autocast(
    device_type="cuda",
    dtype=torch.bfloat16,
):
    logits = model(input_ids)

    loss = F.cross_entropy(
        logits.reshape(-1, vocab_size),
        target_ids.reshape(-1),
    )

loss.backward()

torch.nn.utils.clip_grad_norm_(
    model.parameters(),
    max_norm=1.0,
)

optimizer.step()
scheduler.step()
18. Cross Entropy Loss 我现在怎么理解
模型会在每一个位置对整个词表打分。
比如正确答案是:
get
但是模型最看好:
Linux
Cross Entropy 就会衡量:
模型对正确答案到底有多不自信。
模型刚初始化时,如果 vocab 大概是 1500,随机预测的初始 loss 理论上大概接近:
ln(1500) ≈ 7.31
这个数量级非常有参考意义。
19. Backward 到底做了什么
这一句:
loss.backward()
会把梯度一路从:
Loss
↓
LM Head
↓
Block 8
↓
Block 7
↓
...
↓
Block 1
↓
Embedding
算回去。
也就是说,每一个参数都会知道:
我应该往哪个方向改
改多少
然后:
optimizer.step()
才真正修改参数。
20. 后台训练
为了让服务器自己跑,我最终用:
nohup python -u scripts/train.py \
  --max-steps 2000 \
  --batch-size 16 \
  --seq-len 128 \
  --learning-rate 3e-4 \
  --warmup-steps 100 \
  --save-every 100 \
  --log-every 10 \
  > logs/train.log 2>&1 &
查看日志:
tail -f logs/train.log
查看 GPU:
nvidia-smi
Checkpoint 每 100 step 保存一次:
step_000100.pt
step_000200.pt
...
最终:
final.pt
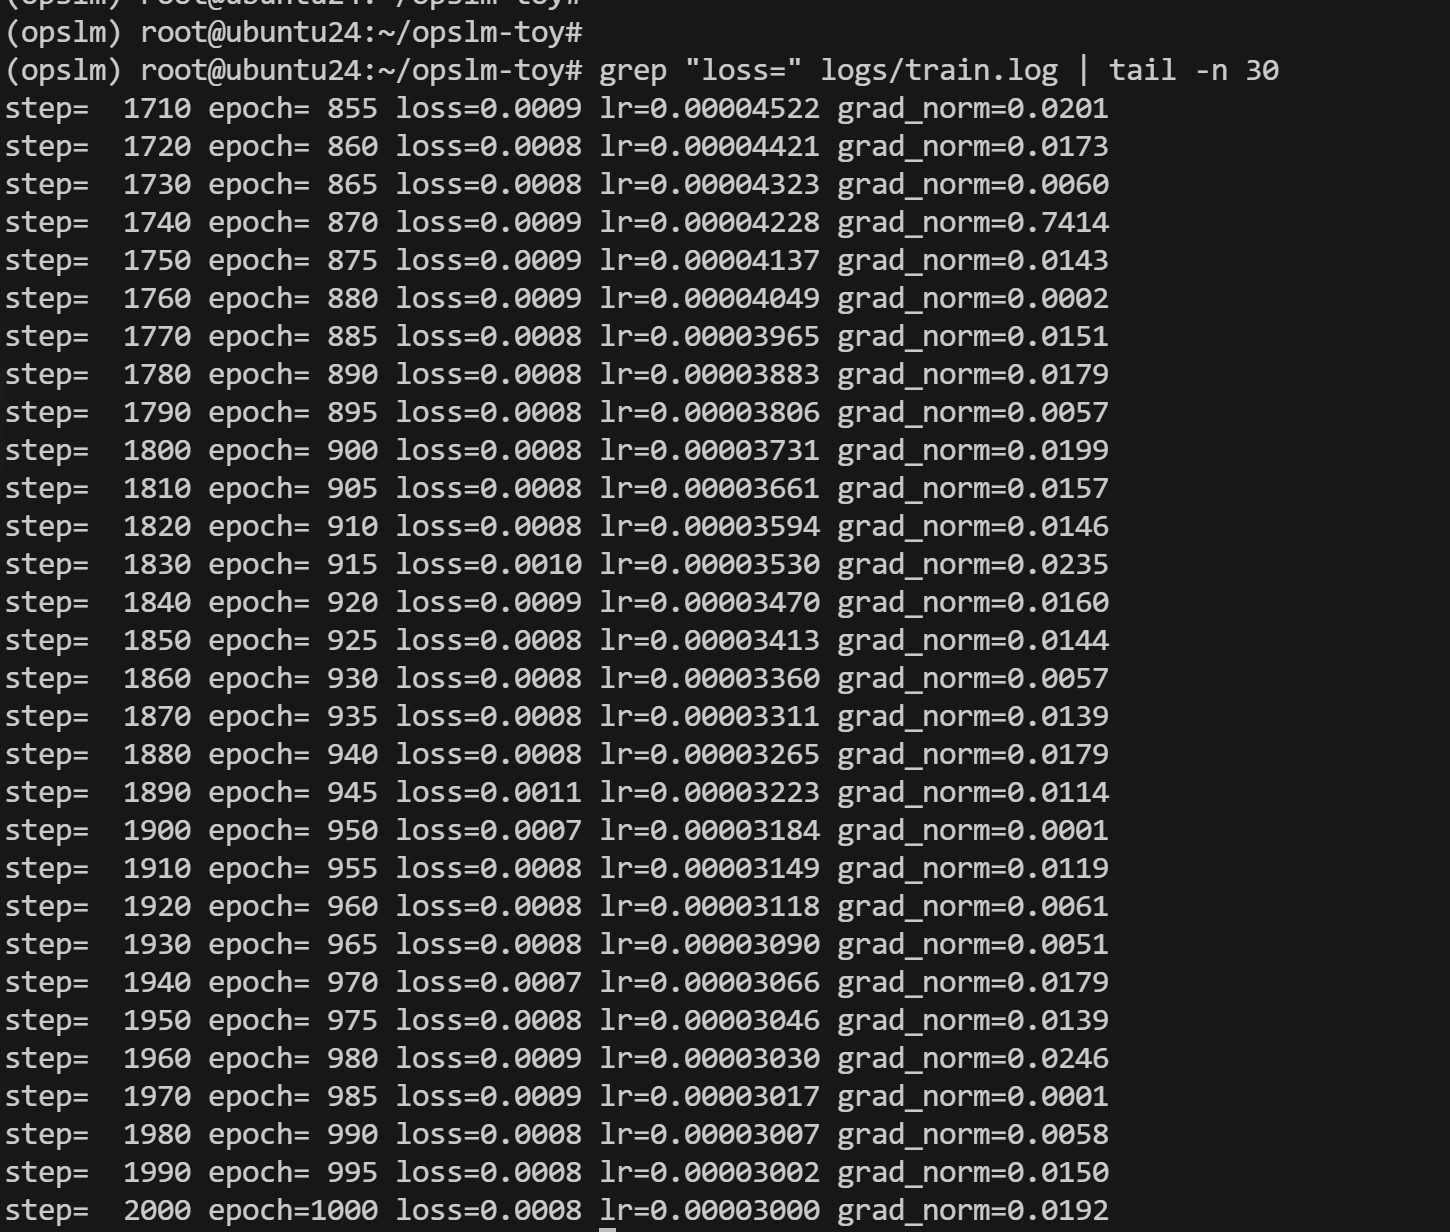
21. 第一次训练结果
最终:
Training step: 2000
Training loss: 0.0009591744747012854
这个 loss 低得非常夸张。
一开始我第一反应是:
模型是不是练得特别好了?
后来一看生成结果,马上就明白了:
不是模型变强了,而是数据太少,它把训练集背下来了。
22. 第一次生成
训练完成后先确认 checkpoint:
ls -lh checkpoints
然后第一次生成:
python scripts/generate.py \
  --checkpoint checkpoints/final.pt \
  --prompt "Linux" \
  --max-new-tokens 100 \
  --temperature 0.8 \
  --top-k 20
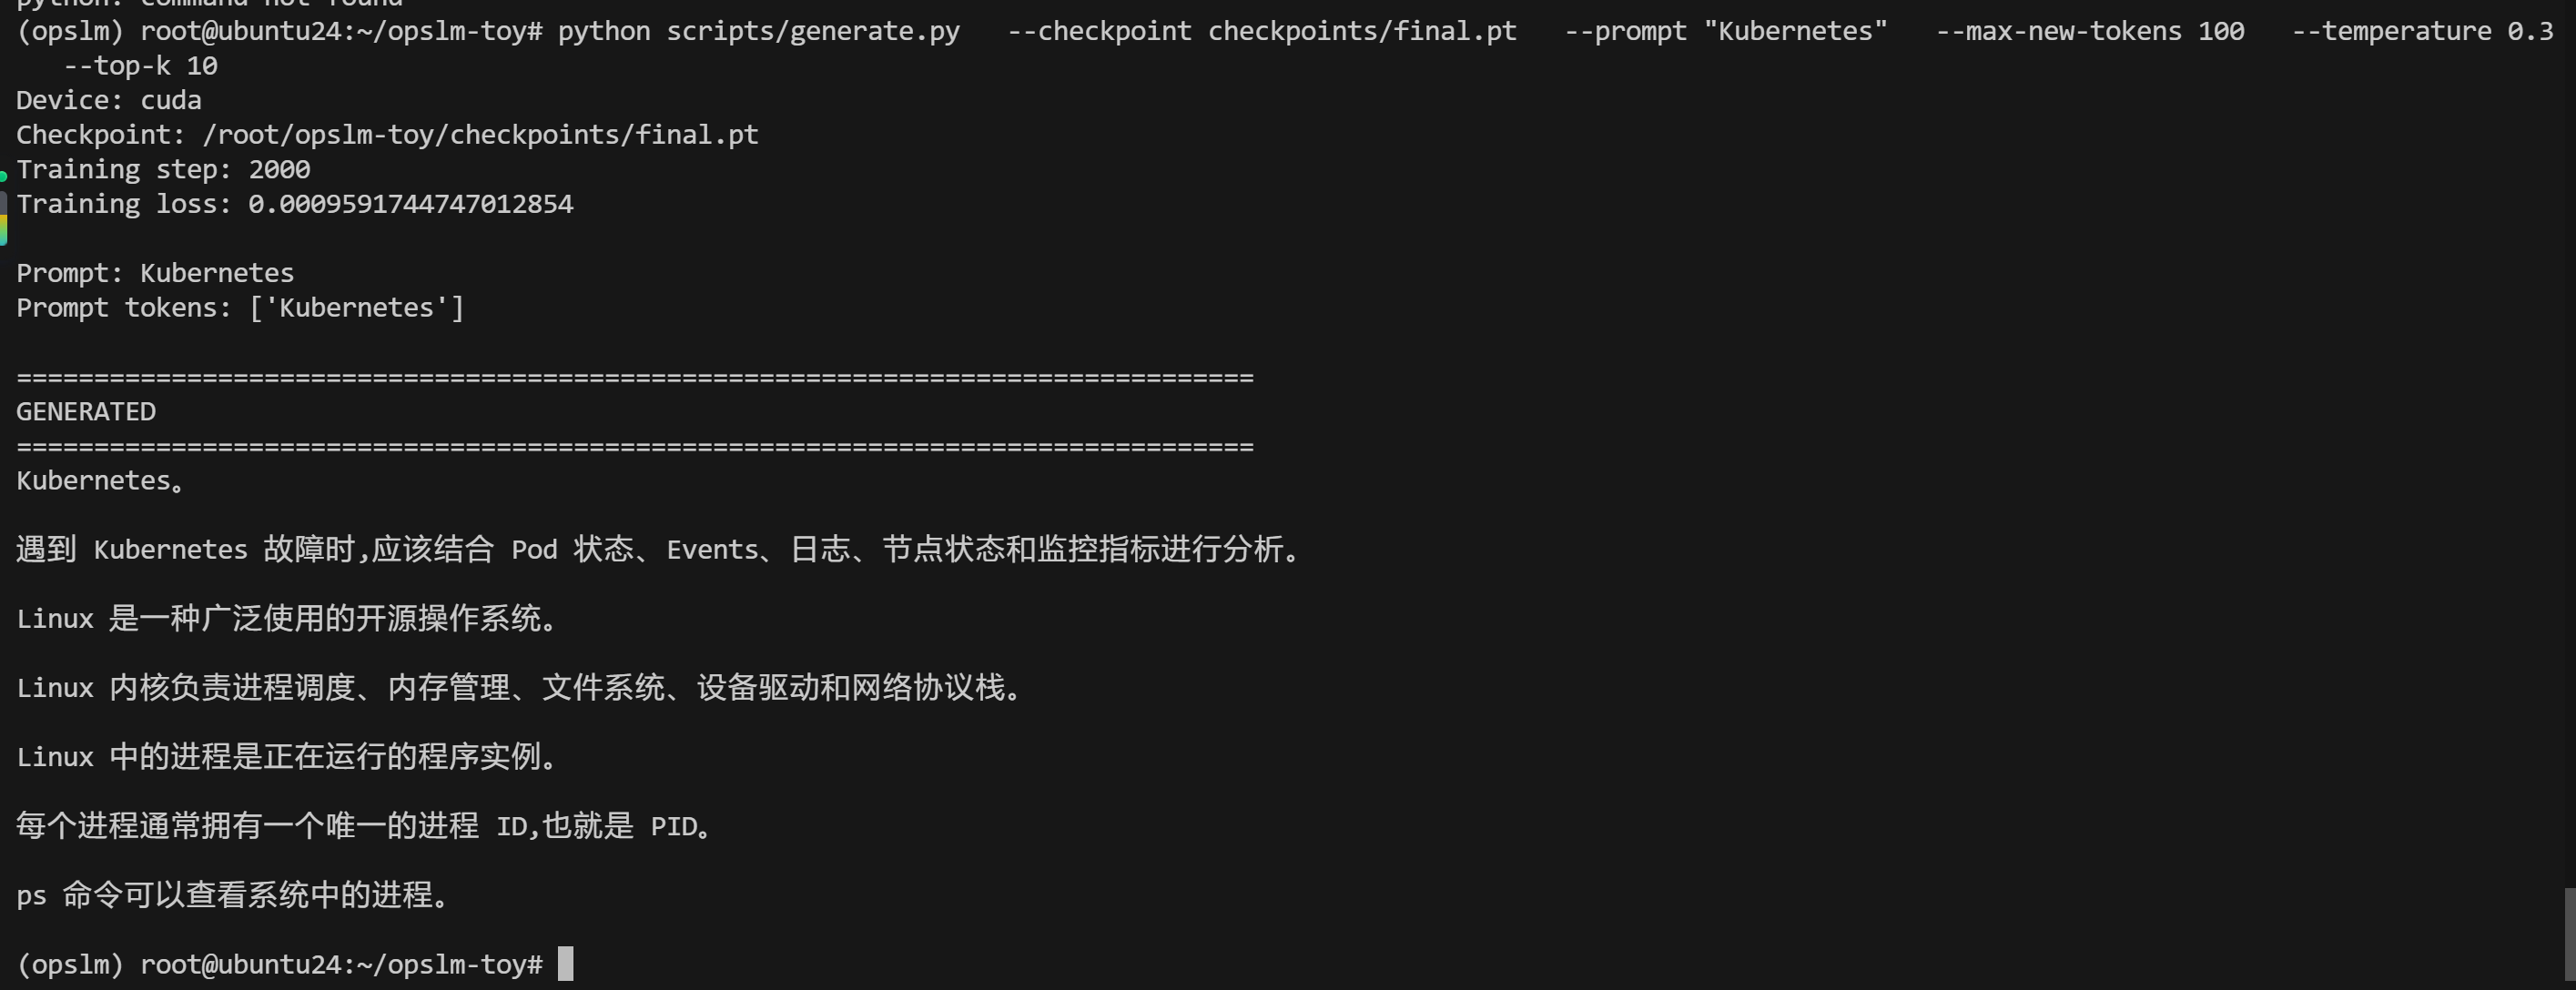
再测试 Kubernetes:
python scripts/generate.py \
  --checkpoint checkpoints/final.pt \
  --prompt "Kubernetes" \
  --max-new-tokens 100 \
  --temperature 0.3 \
  --top-k 10
Prompt:
Kubernetes
生成:
Kubernetes。
遇到 Kubernetes 故障时,应该结合 Pod 状态、Events、日志、节点状态和监控指标进行分析。
Linux 是一种广泛使用的开源操作系统。
Linux 内核负责进程调度、内存管理、文件系统、设备驱动和网络协议栈。
Linux 中的进程是正在运行的程序实例。
每个进程通常拥有一个唯一的进程 ID,也就是 PID。
ps 命令可以查看系统中的进程。
这个结果非常像训练语料本身。
而且 Kubernetes 说完以后突然跳到 Linux,很可能是因为我原始 cleaned.txt 里不同主题文本被拼接成了一个连续 Token Stream。
模型不仅记住了内容,还记住了某些“文档顺序关系”。
23. 第二次测试:Pending
我实际执行的是:
python scripts/generate.py \
  --prompt "一个 Pod 一直处于 Pending 状态" \
  --max-new-tokens 100 \
  --temperature 0.3 \
  --top-k 10
Prompt:
一个 Pod 一直处于 Pending 状态
生成:
一个 Pod 一直处于 Pending 状态。

当系统发 HTTP 不需要�信息和事件。

kubectl logs 可以查看容器日志。

kubectl exec 可以进入容器执行命令。

Pod 处于 Pending 状态时,可能是因为资源不足、调度限制或者存储问题。

Pod 出现 CrashLoopBackOff 时,通常表示容器启动后不断退出并重新启动。

排查 CrashLoopBackOff 时应该先查看容器日志和 Pod Events。

OOMKilled 通常表示容器超过了
这个结果很有意思。
它说明模型已经不是纯随机输出了。
它学到了:
Pod
Pending
资源不足
调度
存储
CrashLoopBackOff
Events
OOMKilled
这些词之间存在某种领域关联。
但是它也明显是在顺着训练语料继续背。
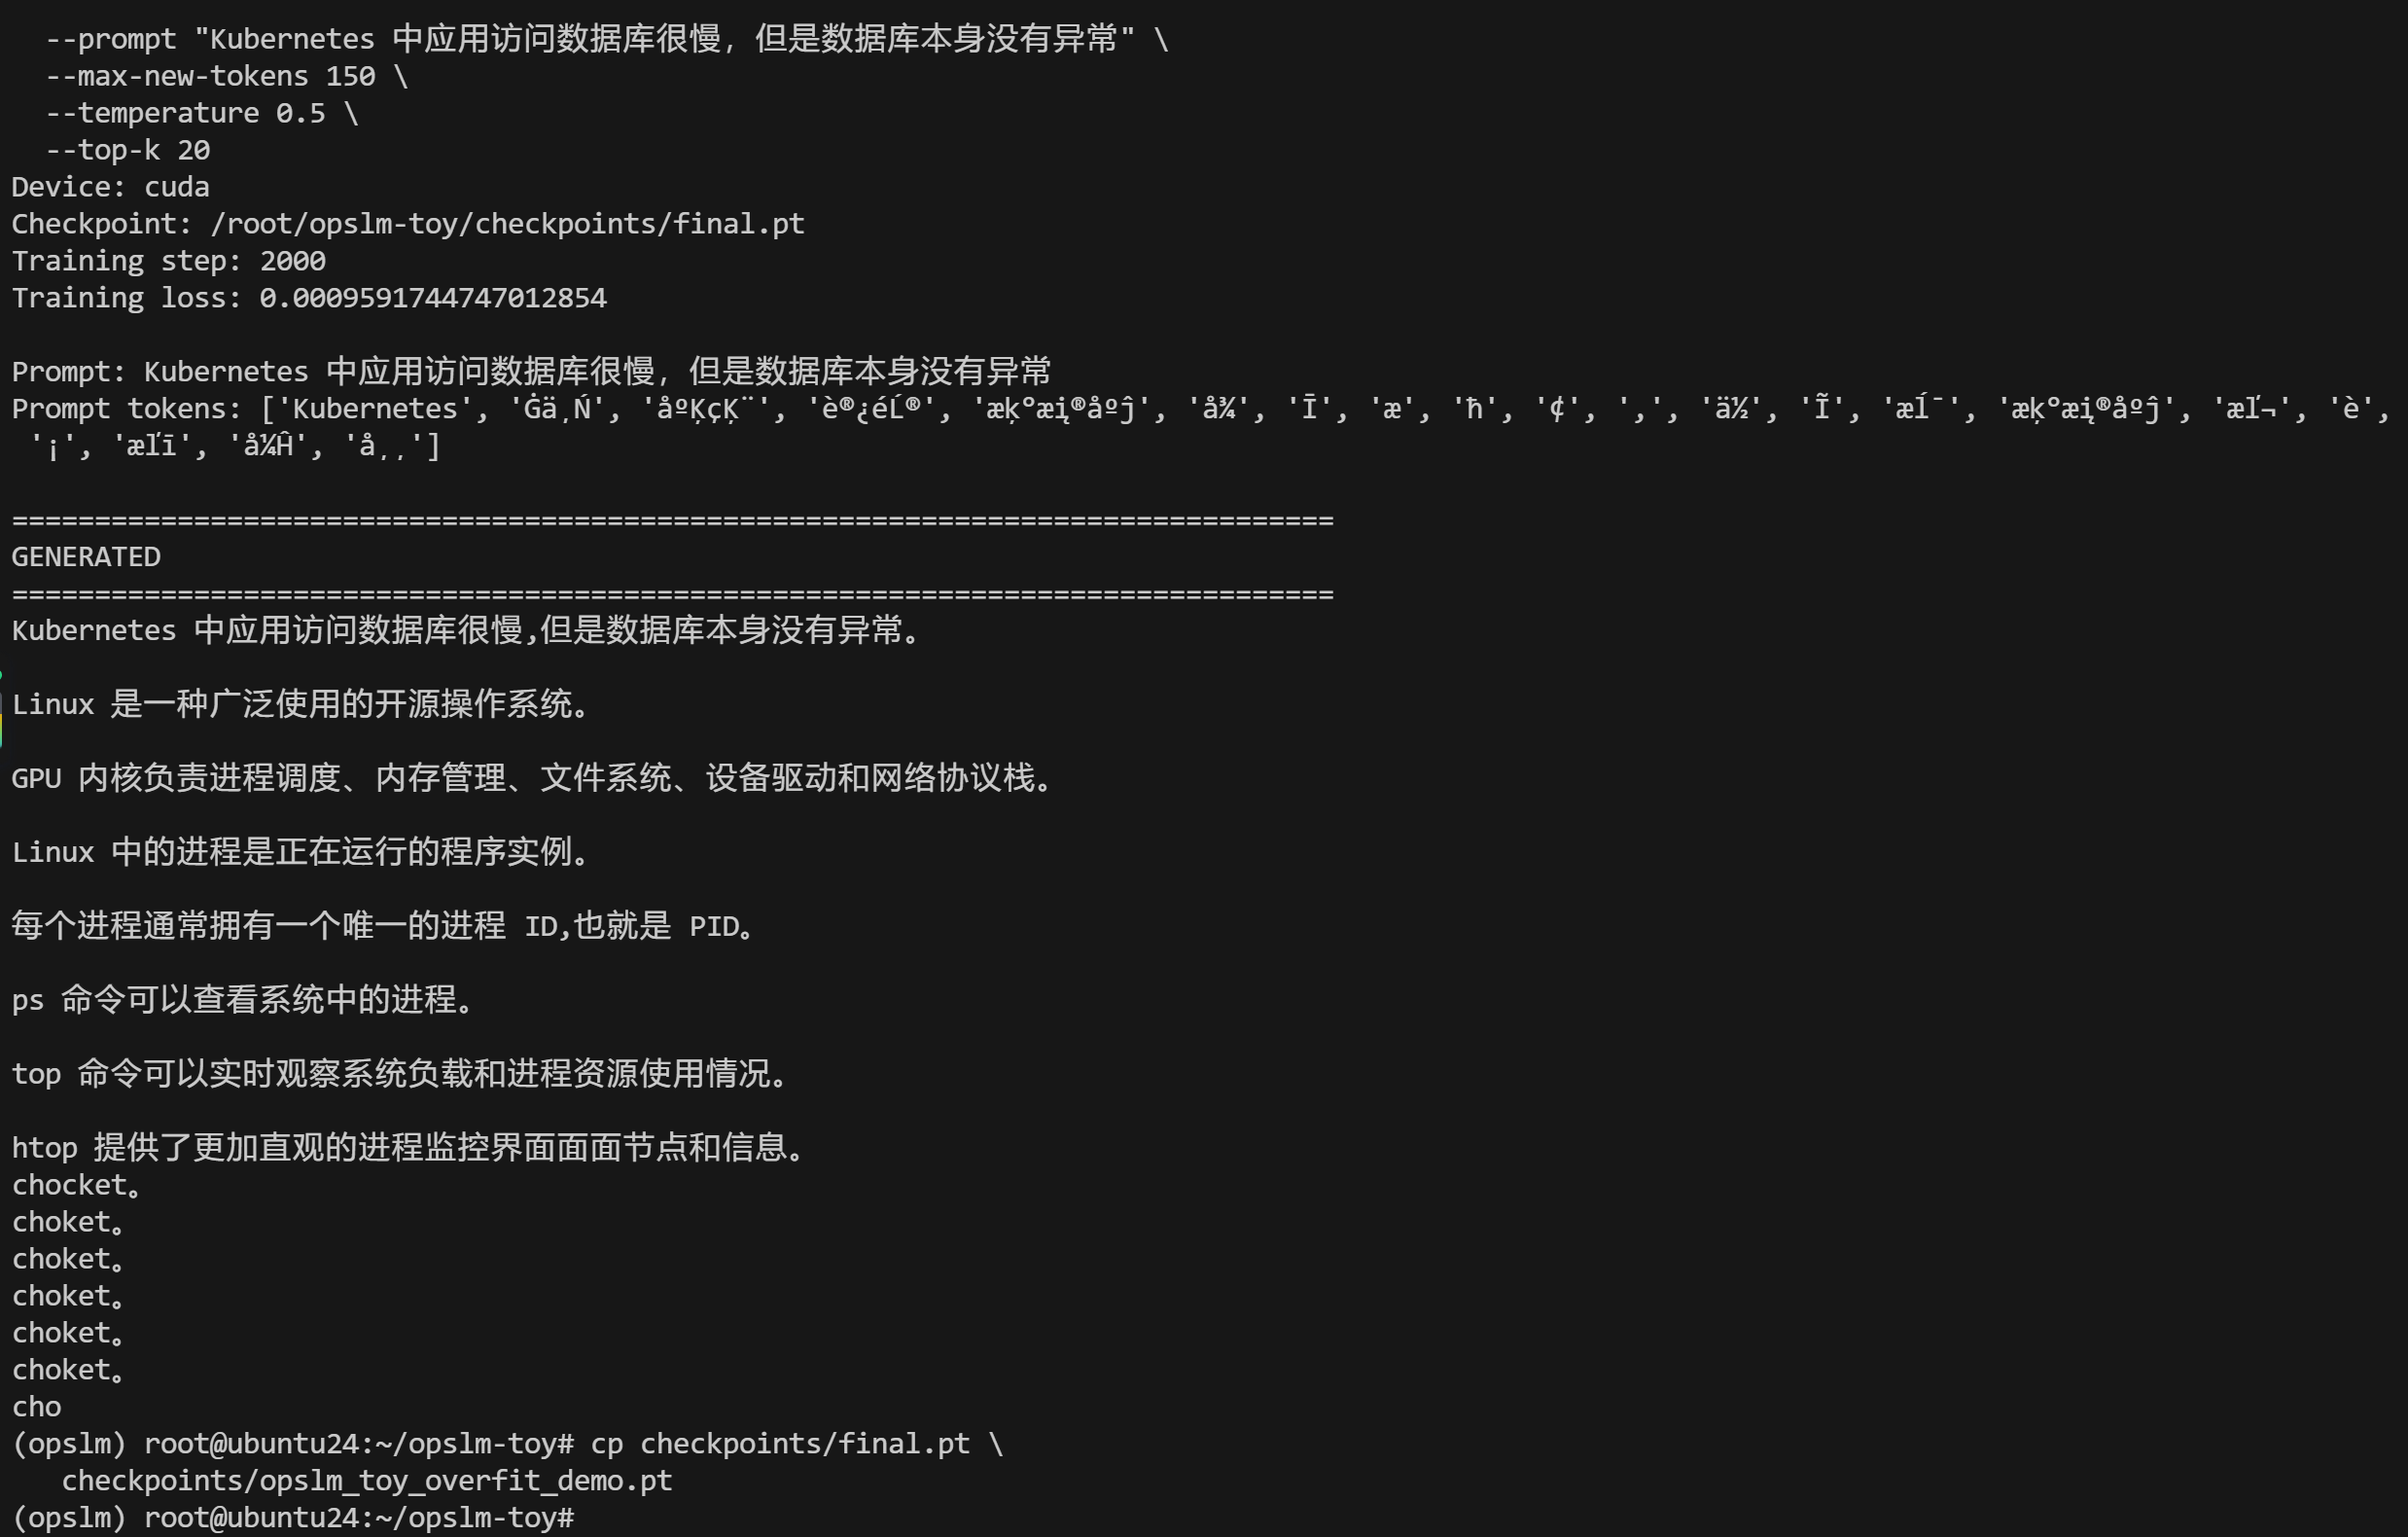
24. 第三次测试:真正的泛化问题
为了验证它是不是只会背训练集,我故意用了训练语料里没有原样出现过的问题:
python scripts/generate.py \
  --prompt "Kubernetes 中应用访问数据库很慢,但是数据库本身没有异常" \
  --max-new-tokens 150 \
  --temperature 0.5 \
  --top-k 20
Prompt:
Kubernetes 中应用访问数据库很慢,但是数据库本身没有异常
生成:
Kubernetes 中应用访问数据库很慢,但是数据库本身没有异常。

Linux 是一种广泛使用的开源操作系统。

GPU 内核负责进程调度、内存管理、文件系统、设备驱动和网络协议栈。

Linux 中的进程是正在运行的程序实例。

每个进程通常拥有一个唯一的进程 ID,也就是 PID。

ps 命令可以查看系统中的进程。

top 命令可以实时观察系统负载和进程资源使用情况。

htop 提供了更加直观的进程监控界面面面节点和信息。

choket。
choket。
choket。
choket。
...
这段输出让我彻底确定:
它会记忆,会局部组合,但泛化能力很弱。
25. 我第一次真正看到“错误组合”
最典型的一句:
GPU 内核负责进程调度、内存管理、文件系统、设备驱动和网络协议栈。
原训练语料显然是:
Linux 内核负责进程调度、内存管理、文件系统、设备驱动和网络协议栈。
模型把:
GPU
和:
Linux 内核负责...
错误拼在了一起。
这说明它已经学会了一些局部句式模式,但是没有真正理解语义。
这也是小模型 + 小数据特别典型的现象。
26. Repetition Loop:为什么会一直 choket
后面生成:
choket。
choket。
choket。
...
这不是代码死循环。
而是自回归生成进入了一个高概率闭环。
生成过程是:
当前文本
↓
预测下一个 Token
↓
把刚预测的 Token 拼回输入
↓
继续预测
一旦某个局部模式形成:
choket -> 。
。 -> choket
模型就可能一直循环。
以后可以通过:
- repetition penalty;
- top-p;
- 更好的数据;
- 更多训练语料;
- 更合理的 EOS 学习;
来缓解。
但第一阶段最根本的问题依然是:
数据太少。
27. Byte-level Tokenizer 为什么会出现 �
这次生成里还出现过:
�
Byte-level BPE 理论上可以表示任意 UTF-8 字节,因此不会遇到传统意义上的 OOV。
但“Tokenizer 能表示任意 UTF-8”并不等于“模型一定生成合法 UTF-8 序列”。
一个汉字一般由多个 UTF-8 byte 组成。
如果模型生成了一半 byte 组合,没有组成完整字符,那么 decode 时就可能出现:
�
这个现象在小数据、小模型阶段很容易观察到。
28. 这次实验到底证明了什么
第一阶段我认为已经完成了它的使命。
我亲手验证了:
原始文本
↓
Tokenizer
↓
Token IDs
↓
Embedding
↓
Self-Attention
↓
Multi-Head Attention
↓
MLP
↓
Transformer Block
↓
8 层 Decoder-only Transformer
↓
LM Head
↓
Logits
↓
Cross Entropy
↓
Backward
↓
AdamW
↓
Checkpoint
↓
自回归生成
这一整条链路是真实可工作的。
29. 这次实验没有证明什么
它没有证明:
OpsLM 已经会推理
OpsLM 已经理解 Kubernetes
OpsLM 已经能处理真实 SRE 问题
OpsLM 泛化很好
相反,它更多证明了:
模型可以拟合训练数据
模型能记忆局部模式
模型能学到词之间的关联
模型会发生严重过拟合
模型会发生生成退化
30. Training Loss 很低不等于模型很强
这是我这次最大的收获之一。
最后:
train loss = 0.000959
看起来非常漂亮。
但真正拿一个训练语料里没有的复杂问题去问,它马上暴露问题。
所以:
Training Loss 很低
≠
Validation Loss 很低
≠
模型泛化很好
≠
模型理解了知识
≠
模型会推理
它只代表:
模型非常擅长拟合训练集。
31. 为什么下一步不能直接上 150M
一开始我的规划里还有一个更正式的:
OpsLM-150M
但是做完第一阶段以后,我决定暂时不放大模型。
原因很简单:
30M 参数 + 几十 KB 数据
已经严重过拟合。
如果直接换成:
150M 参数 + 几十 KB 数据
结果只会是:
背得更快。
不是变聪明。
32. 第二阶段我准备怎么做
下一阶段重点不再是模型,而是数据和训练工程。
计划:
几十 KB
↓
5~10 MB
↓
50 MB
↓
100~200 MB
同时把 Dataset 改成真正的文档级数据:
Document A
<eos>
Document B
<eos>
Document C
<eos>
而不是所有文本简单拼成一个连续流。
33. 必须加入 Validation Set
第一阶段最大的训练工程缺陷是:
只有 Train Loss
没有 Validation Loss
下一版我要拆成:
data/processed/train.txt
data/processed/val.txt
并同时观察:
train_loss
val_loss
真正有意义的曲线应该类似:
step 100
train_loss = 5.3
val_loss   = 5.4

step 300
train_loss = 2.8
val_loss   = 3.0

step 500
train_loss = 1.5
val_loss   = 2.2

step 800
train_loss = 0.3
val_loss   = 3.1
这个时候就能非常直观地看到:
前期:一起下降
↓
中期:Validation 最好
↓
后期:Train 继续下降,但 Val 开始上升
↓
过拟合
下一阶段真正该保存的也不是:
final.pt
而是:
best.pt
也就是 Validation Loss 最低时的模型。
34. 第一阶段完整复现命令
这一部分是我专门给自己留的“以后从头还原实验”版本。等仓库开源以后,别人也可以基本照着这一段直接跑。
34.1 克隆仓库
git clone https://github.com/noovertime7/opslm-toy.git
cd opslm-toy
如果是自己从空目录搭:
mkdir -p opslm-toy/{data/raw,tokenizer/artifacts,src,scripts,logs,checkpoints}
cd opslm-toy
touch src/__init__.py
34.2 创建 Conda 环境
conda create -n opslm python=3.11 -y
conda activate opslm
python -m pip install torch tokenizers numpy tqdm
确认 Python 和 GPU:
python --version
python - <<'PY'
import torch
print('torch:', torch.__version__)
print('cuda available:', torch.cuda.is_available())
print('cuda runtime:', torch.version.cuda)
if torch.cuda.is_available():
    print('gpu:', torch.cuda.get_device_name(0))
PY

nvidia-smi
34.3 检查原始语料
ls -lh data/raw
wc -l data/raw/*.txt
34.4 清洗语料
python scripts/clean_text.py
ls -lh data/cleaned.txt
wc -l data/cleaned.txt
head -n 20 data/cleaned.txt
34.5 训练 Tokenizer
python tokenizer/train_tokenizer.py
ls -lh tokenizer/artifacts/tokenizer.json
python tokenizer/test_tokenizer.py
34.6 验证模型各组件
python scripts/test_embedding.py
python scripts/test_attention.py
python scripts/show_attention.py
python scripts/test_multihead_attention.py
python scripts/test_mlp.py
python scripts/test_attention_mlp.py
python scripts/test_block.py
python scripts/test_residual.py
python scripts/test_model.py
python scripts/test_initialization.py
34.7 验证 Dataset 和 Next Token Prediction
python scripts/test_dataset.py
python scripts/show_next_token_data.py
python scripts/test_dataloader.py
python scripts/test_dataset_model.py
python scripts/test_next_token_prediction.py
python scripts/show_topk_predictions.py
这里至少要确认:
Shift relationship correct: True
以及:
Input:  [B,T]
Target: [B,T]
Logits: [B,T,V]
34.8 先做 10 Step 冒烟训练
mkdir -p logs checkpoints

python -m py_compile scripts/train.py

python scripts/train.py \
  --max-steps 10 \
  --batch-size 16 \
  --seq-len 128 \
  --save-every 10 \
  --log-every 1
检查 checkpoint:
ls -lh checkpoints
34.9 后台训练 2000 Step
nohup python -u scripts/train.py \
  --max-steps 2000 \
  --batch-size 16 \
  --seq-len 128 \
  --learning-rate 3e-4 \
  --warmup-steps 100 \
  --save-every 100 \
  --log-every 10 \
  > logs/train.log 2>&1 &
记录 PID:
echo $!
确认进程:
ps -ef | grep '[t]rain.py'
看 GPU:
nvidia-smi
实时看日志:
tail -f logs/train.log
查看最开始和最后的 Loss:
grep 'loss=' logs/train.log | head -n 20
grep 'loss=' logs/train.log | tail -n 30
34.10 断点续训
如果训练中断,可以从最近 checkpoint 恢复,例如:
python scripts/train.py \
  --max-steps 2000 \
  --resume checkpoints/step_000500.pt
34.11 文本生成
python scripts/generate.py \
  --checkpoint checkpoints/final.pt \
  --prompt "Kubernetes" \
  --max-new-tokens 100 \
  --temperature 0.3 \
  --top-k 10
测试 Pending:
python scripts/generate.py \
  --checkpoint checkpoints/final.pt \
  --prompt "一个 Pod 一直处于 Pending 状态" \
  --max-new-tokens 100 \
  --temperature 0.3 \
  --top-k 10
测试训练集外组合问题:
python scripts/generate.py \
  --checkpoint checkpoints/final.pt \
  --prompt "Kubernetes 中应用访问数据库很慢,但是数据库本身没有异常" \
  --max-new-tokens 150 \
  --temperature 0.5 \
  --top-k 20
34.12 保存第一阶段实验模型
cp checkpoints/final.pt \
  checkpoints/opslm_toy_overfit_demo.pt
到这里,第一阶段实验就可以完整复现。
35. 第一阶段我真正学会的概念
Tokenizer
把文本变成 Token ID。
文本 -> Token -> ID
Embedding
把离散的 Token ID 转成连续向量。
ID -> 512维向量
Position Embedding
告诉模型 Token 在序列中的位置。
因为只看 Token Embedding:
A B C
和:
C B A
只是同一批向量,模型需要额外的位置信息。
Q / K / V
我现在可以粗略理解为:
Q:我现在想找什么信息
K:我这里有什么信息可以被匹配
V:真正被拿走的内容
Causal Mask
防止模型偷看未来答案。
Multi-Head Attention
让模型可以同时学习多种 Token 关系。
MLP
让每个 Token 的内部表示进一步进行非线性加工。
Residual Connection
不彻底覆盖旧信息,而是在原表示基础上增量修改。
LayerNorm
帮助网络保持数值尺度稳定。
Logits
模型对词表里每个 Token 的原始打分,不是概率。
Softmax
把 logits 转成概率分布。
Cross Entropy
衡量模型对正确 Token 有多不自信。
Backward
从 Loss 反向计算所有参数的梯度。
Optimizer
根据梯度真正修改模型参数。
Checkpoint
保存的不只是模型权重,还应该包含:
model_state_dict
optimizer_state_dict
scheduler_state_dict
step
loss
config
这样才能真正恢复训练。
Overfitting
训练集越来越熟,但对没见过的数据越来越差。
这次 loss=0.000959 就是一个非常鲜活的例子。
36. 第一阶段最值得保留的 Checkpoint
我会把这次严重过拟合但非常有教学价值的模型单独保存:
cp checkpoints/final.pt \
  checkpoints/opslm_toy_overfit_demo.pt

ls -lh checkpoints/opslm_toy_overfit_demo.pt
我准备把最终模型额外保存成:
cp checkpoints/final.pt \
   checkpoints/opslm_toy_overfit_demo.pt
这个模型以后不是拿来用,而是作为:
“30M 模型在几十 KB 数据上严重过拟合”
的实验样本。
37. 我的阶段性结论
这次实验让我对“训练语言模型”这件事的理解发生了很大变化。
以前我看到:
Attention
Transformer
Loss
Backward
更多还是概念。
真正自己写过一遍以后,我发现语言模型最底层并没有那么神秘。
它最终还是:
矩阵乘法
线性层
Softmax
残差
归一化
Loss
梯度
参数更新
真正困难的地方,反而在模型规模变大以后出现:
- 数据质量;
- 数据规模;
- 分布式训练;
- 显存;
- 通信;
- Checkpoint;
- 训练稳定性;
- 评估;
- 推理效率;
- GPU 调度。
这也正好和我本身做 SRE / AI Infra 的方向开始接上了。
第一阶段,我解决的是:
模型到底是怎么从零开始学会预测下一个 Token 的?
第二阶段,我准备解决的是:
怎么让它不只是把教材背下来,而是真的开始拥有一点泛化能力?
38. 下一篇准备写什么
第二部分我准备继续做:
1. 扩大运维 / AI Infra 训练语料
2. 文档级数据切分
3. Train / Validation Split
4. Validation Loss
5. Best Checkpoint
6. Early Stopping 思路
7. 更合理的数据混合
8. 观察真正的过拟合曲线
9. 对比不同 Checkpoint 的生成效果
10. 决定是否扩大到 150M
等这部分做完,我再考虑:
RoPE
RMSNorm
SwiGLU
FlashAttention
更大的 Context
更高效的 Multi-Head Attention
以及后面的:
Continued Pretraining
SFT
DPO
领域模型
AI Infra / SRE Agent
39. GitHub 开源说明
这个项目后续会整理到:
https://github.com/noovertime7/opslm-toy
我希望仓库至少包含:
README.md
requirements.txt 或 environment.yml
data/raw/                 # 可公开的示例训练数据
tokenizer/                # Tokenizer 训练与测试
src/                      # 模型核心实现
scripts/                  # 清洗、测试、训练、生成脚本
博客文档/                  # 实验复盘
我不会把大型 checkpoint 直接提交进普通 Git 历史。模型权重更适合放到 GitHub Release、Git LFS 或单独的模型托管平台。
如果我要第一次推送仓库,大致会是:
git init
git add .
git commit -m "feat: first OpsLM-Toy experiment"
git branch -M main
git remote add origin https://github.com/noovertime7/opslm-toy.git
git push -u origin main
正式推送前,我还会补 .gitignore,至少排除:
__pycache__/
*.pyc
logs/*.log
checkpoints/*.pt
.env
结尾
这是我第一次真正从随机权重开始,把一个 Decoder-only Transformer 从零写出来,并亲手看到它:
不会说话
↓
Loss 很高
↓
开始学习
↓
Loss 不断下降
↓
能生成领域文本
↓
把训练集背穿
↓
出现错误组合
↓
出现重复退化
这个过程比直接下载一个开源模型有意思得多。
因为从这一刻开始,我再看到:
Tokenizer
Attention
KV Cache
Loss
Context Length
GPU Memory
Checkpoint
这些词的时候,我脑子里不再只是一个抽象概念,而是能想到它在整个模型里的具体位置。
第一阶段结束。
下一阶段:
让 OpsLM 从“会背书”开始走向“会一点泛化”。